Оставете AI да чернови, не да публикува: безопасен модел за съдържание с помощта на AI
Два езика, двойно писане
Всяка статия за сайта на Arc AI започва като обикновен документ - със заглавие, текст и нищо друго. Вмъкването ѝ в CMS означаваше пренаписване на заглавието, адреса, обобщението, SEO полетата и надписа на изображението, а после всичко отново на другия език. Бавната работа подканва измислянето на преки пътища, а точно така едно мета описание завършва копирано от грешната статия. Затова екипът насочи езиков модел към документа и го помоли да произведе всичко освен частите, за които все още трябва да мисли човек: кое е вярно, кое е готово и кое да се публикува.
Работата, която си струва да поверите на AI
Слъгът може да съдържа само определени знаци. Мета описанието има твърда дължина. Alt текстът трябва да съществува. Категорията трябва да е една от фиксиран списък. Нищо от това не изисква преценка, а аритметика и разпознаване на образци; работа, с която моделът се справя добре, а човек би намерил за досадна.
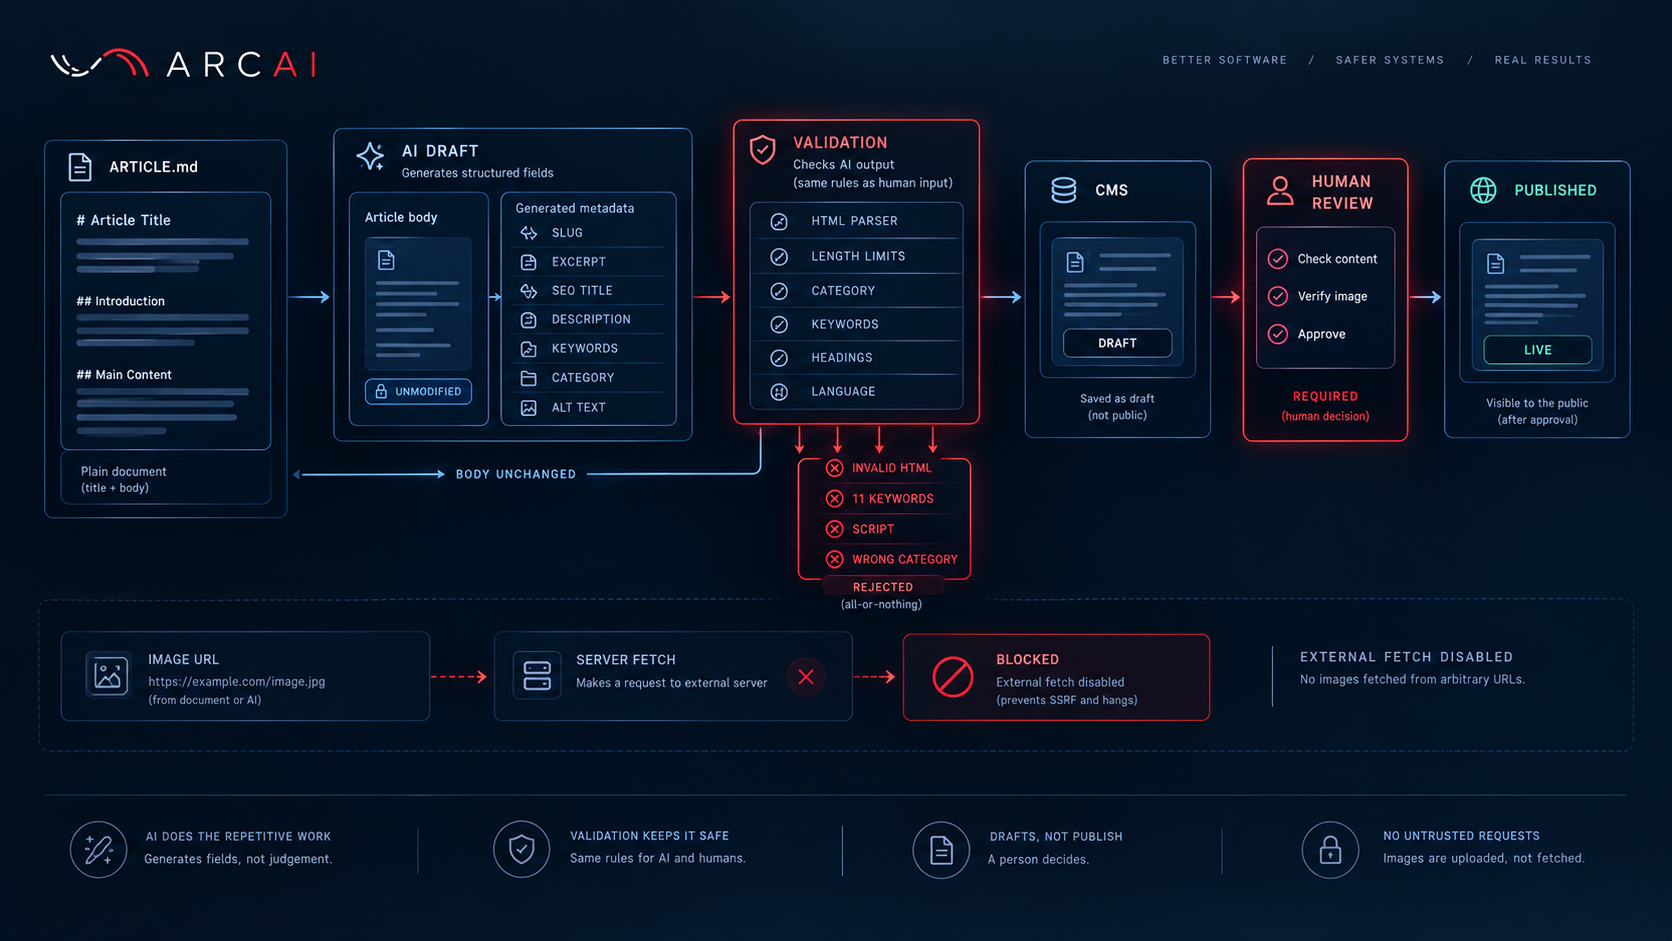
Задачата: прочети документа, произведи слъг, кратко резюме, SEO заглавие до 60 знака, описание до 160, до десет ключови думи, категория от съществуващия списък, alt текст за главното изображение, и превод само когато е предоставен файл на другия език. Нищо за това дали статията трябва да съществува. Нищо за натискане на бутона за публикуване.
Промптът се генерира от същите ограничения, които валидаторът на CMS налага, лимитите за знаци, тавана на ключовите думи, списъка с категории, така че преместването на лимит на едно място го премества и на другото. Два списъка, поддържани в синхрон на ръка, рано или късно се разминават; един списък, прочетен два пъти, не може.
Преобразувайте, не пренаписвайте
Помолете модел да "изчисти" параграф и той ще го направи, независимо дали сте го поискали. Точно това CMS импортът не може да си позволи: думите в текста са тези, които авторът е избрал, и трябва да стигнат до базата данни непроменени.
Инструкцията е умишлено ограничена: не пипай текста, не превеждай, освен ако не е предоставен файл на другия език, извличай само изброените полета от онова, което вече е на страницата. Звучи като малко ограничение. На практика това е разликата между инструмент за импорт и инструмент за пренаписване, който също импортва неща.
Това доверие изобщо не важи за онова, което се връща
Каквото и да върне моделът, се третира като файл, качен от непознат, със същите проверки, през които трябва да мине текст, въведен от редактор, без изключение за източника.
HTML минава през истински парсер, не регулярен израз, проверен срещу кратък списък с разрешени тагове. Всичко останало се премахва, скриптовете се отхвърлят категорично, външните и вградените изображения се блокират. Текстът трябва да съдържа точно едно основно заглавие. Един-два безобидни навика, като например модел, който обвива отговора си в блок с код, може да се толерира; нищо повече.
Всяко поле за двата езика се проверява, преди да се запише каквото и да е. Дори да има една грешка където и да е, грешна дължина, единайсета ключова дума, означава нула записи. Няма версия, при която английската част се запазва, а българската остава счупена. Дори документ, преминал всяка проверка, не се публикува сам. Той се записва като чернова; човек трябва да качи главното изображение ръчно, тъй като изображенията никога не са част от импорта, да прегледа статията и едва тогава може да я публикува.
Не всяка заявка за функционалност стига до реализация
Една заявка се появи рано: да се позволи документът сам да посочва URL адреси на изображения, а сървърът да ги извлича. Това би спестило една стъпка, а също би дало на всеки, редактиращ документа, или на самия модел, начин да накара сървъра на сайта да изпраща заявки към адреси по свой избор.
Сървър, извличащ адрес от качен файл, е добре познат клас от атаки, подправяне на заявки от страна на сървъра, и надежден източник на зависвания дори без злонамереност. Тази функционалност бе отказана. Авторите продължават да качват изображенията ръчно. Понякога най-безопасната функционалност е тази, която никога не се разработи.
Кратък списък за проверка, преди да направите импорт на нещо, написано от AI
- Дали задачата е нещо, което кодът ви наистина може да провери, а не просто да се надява, че е излязло вярно?
- Правилата в промпта генерирани ли са от собствените ви валидатори, вместо копирани на ръка в друг файл, който ще има разминавания?
- Резултатът от AI преминава ли през същата валидация, през която трябва да мине въведеното от човек?
- Импортът по правилото всичко или нищо ли е, с всяка грешка вързана към поле и език?
- Всичко записва ли се като чернова, където човек все още е необходим за публикуването?
- Сървърът ви извлича ли нещо, посочено от AI вътре във файл? Ако да, премахнете го.
Къде остава вашата преценка
Нищо от това не прави модела по-мъдър относно кое е вярно или кое заслужава да излезе под името на Arc AI. То просто върши повтарящата се част от импорта, два пъти, на два езика. Слъгът, SEO полетата, alt текстът: кодът може да ги провери, моделът може да ги генерира. Кое е вярно, кое е завършено и кое се публикува - тези решения остават за човека.